36氪
A股三大指数午间休盘集体下跌,算力硬件板块下挫
36氪获悉,A股三大指数午间休盘集体下跌,沪指跌0.93%,深成指跌2.55%,创业板指跌3.63%;算力硬件、能源设备、化工板块下挫,天孚通信跌超18%,山东墨龙、联盛化学跌超5%;煤炭、电信、银行板块走强,中国卫通涨超5%,中国神华、交通银行、工商银行涨超2%。
76 signalsFocus: Chips / Compute, AI Models
36Kr news flashes usually do not include images.
三星电子在Q3财报中表示,存储需求将进一步增长,需求重心集中在适配新一代CPU/GPU平台的存储产品。伴随个人AI智能代理服务扩张,QLC固态硬盘需求大幅攀升。继续扩大HBM、服务器DRAM以及SSD的销售规模,提升高速服务器DDR5、QLC产品的供货量。(财联社)
36Kr news flashes usually do not include images.
三星电子称,芯片供应短缺问题明年将进一步加剧。
36Kr news flashes usually do not include images.
全球规模最大的数据中心公司之一Equinix(易昆尼克斯)表示,新数据中心项目上线面临的障碍不断增加,这将使现有容量更具价值,并可能增强其市场控制力——包括定价能力。(新浪财经)
This source did not provide an image.
马斯克此番表态,是在社交平台上直接引用并反驳 Counterpoint Research 发布的人形机器人内存DRAM需求测算。
36Kr news flashes usually do not include images.
天相投顾数据显示,截至2026年三季度末,在基金新进前50大重仓股中,主要集中在科技和医药领域。从科技相关公司所属行业看,主要分布在电子、信息技术等行业。包括,MLCC龙头三环集团、PCB龙头景旺电子和芯碁微装、电子龙头立讯精密、模拟芯片龙头圣邦股份等。从医药行业上市公司看,包括健友股份、科源制药、康泰生物、瑞普生物、义翘神州和海尔生物。(上证报)
36Kr news flashes usually do not include images.
随着AI(人工智能)产业化纵深推进,算力需求持续高位运行。万得数据显示,截至10月28日,算力租赁板块53家上市公司中,已有25家披露2026年三季报,其中,4家企业前三季度同比减亏,2家同比扭亏,7家归母净利润实现同比增长。苏商银行特约研究员武泽伟表示,算力租赁行业上市公司业绩出现显著分化的原因,一部分是企业营收高速增长,却受一次性收益扰动、资产折旧摊销拖累,利润短期承压;另一部分是企业凭借优质长单落地与商业模式迭代,前三季度业绩表现不俗。(证券日报)
36Kr news flashes usually do not include images.
今年以来,AI服务器迭代升级,印制电路板(PCB)用料规格随之提升,超薄、低介电特种电子布需求集中释放,电子布行业迎来结构性量价齐升。目前,电子布价格已经达到近十年高位。10月份涨价落地后,有市场声音称,覆铜板、PCB有望向少布、无布化升级,未来相关产业链用布量或减少。对此,多位业内人士表示,今年以来,AI服务器、高速交换机、车载PCB等带来的高端基材增量需求让电子布价格连续上涨。目前,电子布在很多方面都具有优势,覆铜板等领域少布、无布化预期更多还是源于成本压力。由于供需整体处于“紧平衡”,电子布11月涨价仍是大概率事件。(中证报)
36Kr news flashes usually do not include images.
在三季度,上半年表现亮眼的科技板块出现调整,公募对科技抱团是否松动的讨论随之升温。一方面,电子、通信两大行业的公募投资占比仍处高位,资金并未系统性撤离;另一方面,前期投向AI算力产业链的基金经理操作分化,坚守算力者调整细分赛道,先行者转向AI应用端,谨慎者均衡配置,防守者清仓换赛道。展望后市,基金经理长期看好AI产业的共识未变,但对估值与结构性方向的判断正趋于精细化。(中证报)
36Kr news flashes usually do not include images.
据知情人士透露,迈威尔科技公司(Marvell Technology)正在就收购数据中心光学器件制造商Lumentum Holdings进行深入谈判。(新浪财经)
36Kr news flashes usually do not include images.
美国司法部已就英伟达收购开源平台Hugging Face的交易将如何影响人工智能领域的竞争展开问询,与此同时,反垄断执法部门仍在推进对这家芯片设计公司行为的多年调查。司法部近期的问询涉及英伟达的收购、投资和销售行为,以及该公司是否曾向客户施压。对于Hugging Face交易,司法部官员询问,这笔收购是否会让英伟达掌控AI领域一个基础性的分发渠道。(新浪财经)
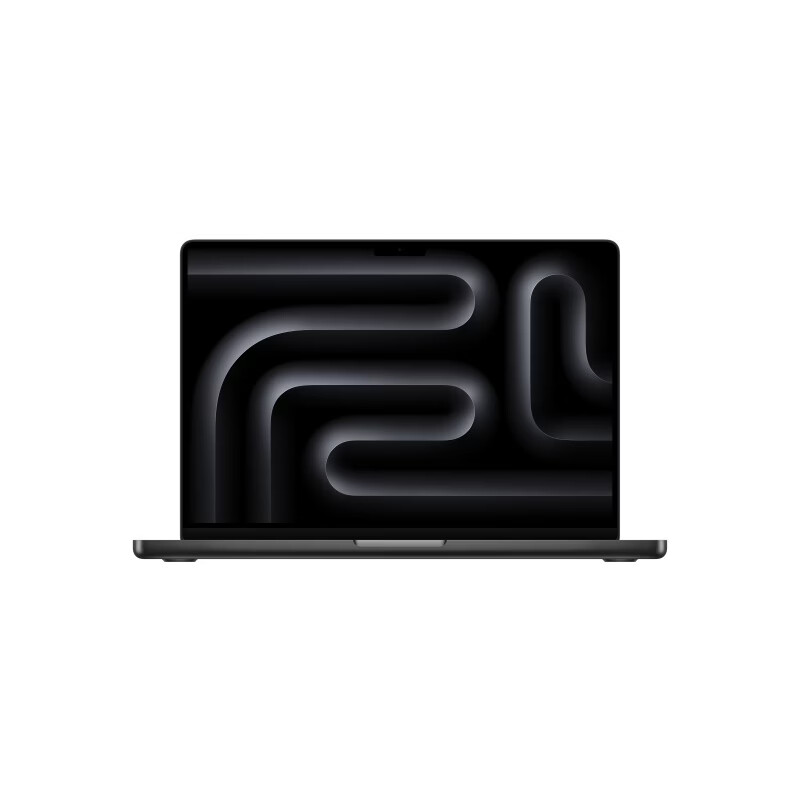
IT之家 10 月 29 日消息,苹果公司 2026 款 MacBook Pro 已于今天(10 月 29 日)凌晨 1 点 10 分开启预购,起售价 15,999 元,最快 11 月 6 日送达。 新款 M6 芯片的 14 英寸 MacBook Pro 继承了上一代外观,可选深空黑色和银色两种配色,配备 3024 x 1964 分辨率 120Hz 显示屏。 该机搭载 M6 芯片,为 12 核中央处理器、12 核图形处理器、双 16 核神经网络引擎规格,官方称该机设备端 AI 性能相对于 13 英寸 M1 机型最高提速至 13 倍。 同时,新款 M6 芯片的 14 英寸 MacBook Pro 机型内存带宽达 170GB/s,比 M5 机型的 153GB/s 有所提升,但性能提升并未延伸到基础款的 16GB 统一内存配置。 技术规格页面显示,16GB 统一内存的选项仍然限制在 153GB/s。与 M5 机型相同,而只有全新的 24GB 和 32GB 配置才拥有更快的 170GB/s 内存带宽。 作为对比,搭载 M5 Pro 芯片的 MacBook Pro 提供 307GB/s 的内存带宽,而搭载 M5 Max 芯片的机型则具有高达 614GB/s 的内存带宽。 京东 11.11 无门槛红包 面额至高 26888 元,每天抽 3 次: 点此抽红包 。 淘宝 11.11 无门槛红包 面额至高 26888 元,每天抽 1 次: 点此抽红包 。
Hacker News usually provides an outbound discussion, not an original image.
Original source: thenewstack.io
by theanonymousone · 43 points · 19 comments, no article summary provided
36Kr news flashes usually do not include images.
36氪获悉,XHEART正式发布大模型芯片X7 Ultra,截至目前,X7系列已量产8个月,累计出货超过20万颗,搭载10款量产车型,获得超过40款车型订单。
36Kr news flashes usually do not include images.
36氪获悉,德科立公告,公司拟投资建设“AI算力及数据中心光连接高端产品产业化能力提升项目”,计划总投资约12亿元。本项目拟购置土地,新建洁净厂房、仓储及配套设施,购置生产与测试设备,搭建高端光连接产品生产线。三类产品分别适配集群内高带宽互联、跨区域长距算力互联调度、大规模算力集群动态全光组网,形成覆盖AI算力全层级互联的产品矩阵。项目建成后,将提升公司高端光通信产品制造水平与规模化交付能力。
This source did not provide an image.
过去三年,中国大模型进步迅速,却始终未能真正站上全球前沿。Epoch AI的能力指数显示,自2023年以来,每一个处于前沿的模型均出自美国,中国模型平均落后约7个月,最短4个月,最长14个月。 与此同时,差距正在持续收窄。 斯坦福大学《2026年AI指数报告》显示,中美最佳模型的性能差距已由2023年5月的三成以上,缩小至2026年3月的约2.7%。DeepSeek-R1在2025年初一度追平美国最强模型,但很快又被拉开距离。 差距不断缩小,为何始终无法反超?根本原因在于训练算力。 据非营利AI研究机构Epoch AI估算,DeepSeek-R1的训练计算量约为4×1024次浮点运算,Qwen3-Max约为1.5×1025次;同期美国的GPT-5约为6.6×1025次,Grok 4约为5×1026次,高出一个数量级。 在算力受限的条件下,中国大模型走出了一条“追赶加提效”的道路。DeepSeek-V3仅用2048张H800完成预训练,依靠混合专家架构和8位精度训练,将正式训练的算力成本压缩至约560万美元(不含前期研发与试验)。同一时期,Meta训练Llama 3.1 405B动用了约1.6万张H100。 然而,提效存在天花板。中国团队的效率创新,美国实验室很快就能吸收,再叠加十倍算力,差距随即重新拉开。更重要的是,效率提升不会减少算力需求,反而会扩大需求。正如19世纪蒸汽机效率大幅提高后,英国的煤炭消耗不降反升,即所谓的“杰文斯悖论”。效率越高,同样的投入能训练出越强的模型,各方追加算力的意愿也就越强。 只要训练算力的差距依然存在,中国大模型就难以跳出“追近、再被拉开”的循环。 AI算力分为训练和推理两类。尽管推理正成为算力需求的主体,但训练决定了能否自主创造和改进前沿模型。美国芯片出口管制瞄准的正是训练所需的高端芯片和互联能力。本文试图回答三个问题:训练算力的需求从何而来?供给的核心是什么?中国的瓶颈在哪里,又该如何突破? 规模定律:模型决定训练算力的需求 大模型为什么越做越大?答案是规模定律(Scaling Law)。 规模定律并非理论推导,而是在实践中反复观察到的经验规律:模型的预测误差随参数量、数据量和计算量的增加,按幂律稳定下降。这意味着,投入多少数据和算力、换来多大的能力提升,可以事先估算。正因为投资回报可以预期,科技巨头才敢于押注千亿美元。 一次训练需要多少计算?若把模型参数想象成千亿个旋钮,训练就是用海量数据反复调试,为每个旋钮找到合适的位置。业界的经验公式是:C≈6×N×D。其中,C为总计算量,N为参数量,D为训练所用的Token(词元)数。系数6源于每处理一个Token,每个参数在前向计算中需做2次浮点运算,在反向传播中需做约4次。 以Meta公开的Llama 3.1 405B为例,4050亿参数、约15.6万亿Token,计算量约为3
36Kr news flashes usually do not include images.
36氪获悉,天眼查App显示,近日,武汉阿基米德半导体有限公司发生工商变更,新增宁德时代新能源科技股份有限公司、小米旗下瀚星创业投资有限公司为股东。该公司成立于2026年1月,法定代表人为张俊锋,注册资本1000万元人民币,经营范围含集成电路设计、集成电路制造、半导体分立器件制造等,现由阿基米德半导体(合肥)有限公司、武汉德雷克投资合伙企业(有限合伙)及上述新增股东等共同持股。
36Kr news flashes usually do not include images.
36氪获悉,10月29日,在郑州举行的2026数据存储产业大会上,中科曙光展示了面向Token时代的最新探索,以“AI数据工厂”推动存储主动参与AI生产全流程,提升Token产出效率。“AI数据工厂”着眼于打通数据使用的各个环节,让AI及时获取所需信息,并复用已有计算结果,升算力利用效率。目前,曙光存储系统已在曙光8000、机器人数据采集与训练、自动驾驶等多场景中应用。